Cada vez más, la cantidad de datos que se obtienen de proyectos —ya sean espaciales, biológicos, informáticos o poblacionales, etc.— alcanza cifras de información que prácticamente nuestra mente no es capaz de procesar.
La sistemática habitual para esta gestión se basa en la fragmentación de los datos; sin embargo, a veces el volumen es tan grande que requiere sistemas con capacidades que hace una década serían impensables.
Hablamos del Telescopio SKA.
Un megaproyecto astronómico (Square Kilometre Array) ubicado en Australia y Sudáfrica que procesa nada más y nada menos que 5 zettabytes al año, o lo que es lo mismo, 5 billones de gigabytes.
Esta sería la cifra:
5.000.000.000.000 GB
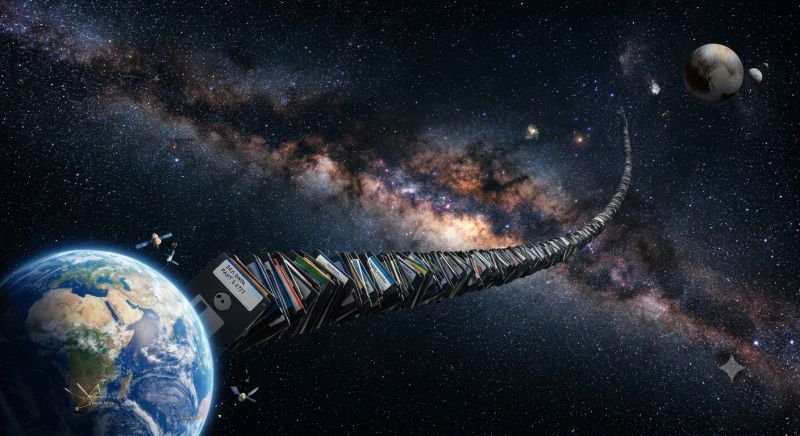
Imagínate unos 3,47 billones de disquetes de los de antaño.
Y para ponerte en perspectiva: si pusiéramos uno encima de otro, crearíamos una torre de 11.458 millones de kilómetros de altura. Sí, podríamos ir a Plutón y volver… disquete a disquete.
Para procesar semejante cantidad de datos (principalmente datos de radiointerferometría que se convierten en imágenes), el sistema se divide en tres etapas:
1- Filtro in situ con supercomputadoras dedicadas en los propios arrays de antenas.
2- Procesamiento de supercomputadoras (guardan archivos «resumidos» de 600 a 700 petabytes).
3- Filtro y gestión global por los países participantes del proyecto.
Y aún no hemos encontrado vida inteligente…
#prontollegara
#cienciadedatos
#bigdata
sellmazon.eu